4,7



Wenn Sie in Bereichen arbeiten, die schnelle und genaue Transkriptionen erfordern, ist die Integration von Spracherkennungs-APIs in Ihren Workflow genau das, was Sie benötigen. Glücklicherweise bieten viele dieser APIs eine kostenlose Option an, sodass Sie sie nutzen können, um Ihren Transkriptionsprozess zu optimieren, ohne Ihr Budget zu belasten.
Um sie zu sortieren, haben wir eine Liste der besten kostenlosen Spracherkennungs-APIs zusammengestellt, zusammen mit ihren wichtigsten Funktionen, Einschränkungen und der Integration in Ihre Projekte. Selbst wenn Sie feststellen, dass diese Optionen Ihre Anforderungen nicht erfüllen, bieten wir auch alternative Empfehlungen an, die möglicherweise besser zu Ihren Bedürfnissen passen.
In diesem Artikel
Teil 1. Beste kostenlose Spracherkennungs-API für Audio-Transkription
Angesichts der wachsenden Nachfrage nach Audio-Transkription in verschiedenen Bereichen wie Content-Erstellung, Bildung und Wirtschaft stellen viele Nutzer häufig die Frage: "Welche kostenlosen APIs oder Online-Dienste gibt es für die Sprache-zu-Text-Konvertierung?"
Sprache-zu-Text-APIs sind für Entwickler unerlässlich, um Spracherkennungsfunktionen in ihre Anwendungen zu integrieren. Als Antwort auf diesen Bedarf bieten wir einen ausführlichen Überblick über die besten heute verfügbaren kostenlosen Sprache-zu-Text-APIs. Dazu gehören Google Cloud Speech-to-Text, Microsoft Azure Speech Service, Speechmatics, AssemblyAI und AWS Transcribe.
1. Google Cloud Sprache-zu-Text API
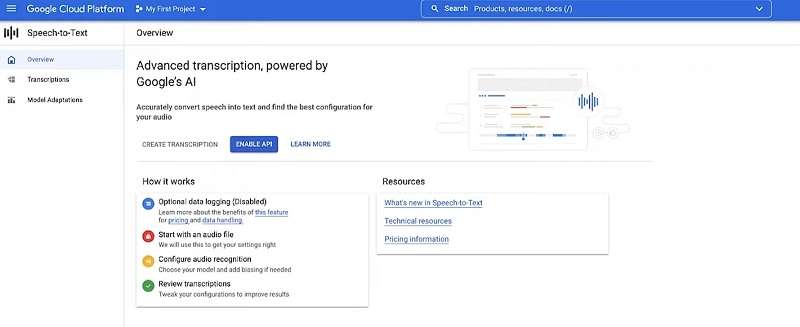
Die Google Cloud Speech-to-Text API ist Teil der Google Cloud Suite und wurde entwickelt, um Audio in genaue Texttranskriptionen umzuwandeln. Mit benutzerfreundlichen APIs können Entwickler Spracherkennungsfunktionen in ihre Anwendungen integrieren. Um diese Sprache-zu-Text-API kostenlos zu nutzen, gewährt Google den Nutzern 60 Minuten kostenlose Transkription. Neue Nutzer können zudem Speech-to-Text und andere Google Cloud-Produkte mit bis zu 300 $ an kostenlosen Credits erkunden.
Hauptfunktionen:
- Nutzt Chirp, Googles fortschrittliches Sprachmodell, das auf Millionen von Stunden Audiodaten und Milliarden von Textsätzen trainiert wurde
- Bietet Unterstützung für 125 Sprachen und Varianten und ist damit für eine vielfältige Nutzerbasis geeignet
- Stellt eine Auswahl trainierter Modelle bereit, die auf spezifische Anwendungsfälle zugeschnitten sind, darunter Sprachsteuerung, Telefonanruf-Transkription und Video-Transkription
- Nutzt Modellanpassungstechniken, um die Genauigkeit häufig verwendeter Wörter zu verbessern, den Wortschatz für die Transkription zu erweitern und die Leistung in geräuschreichen Audioumgebungen zu steigern
Einschränkungen:
- Der kostenlose Tarif erlaubt nur 60 Minuten Transkription pro Monat. Dies reicht möglicherweise nicht für größere Projekte oder häufige Transkriptionsbedürfnisse aus
- Weniger komfortabel für Personen, die mit Google Cloud-Diensten nicht vertraut sind. Sie müssen Audiodateien in einen Google Cloud Storage Bucket hochladen, bevor die Transkription beginnt
- Erweiterte Anpassungsfunktionen sind in der kostenlosen Version möglicherweise nicht vollständig zugänglich
Ideal für: Geringer Transkriptionsbedarf, z. B. für kleine Unternehmen oder Freiberufler, die kurze Interviews, Podcasts oder Meetings transkribieren.
2. Microsoft Azure Speech API
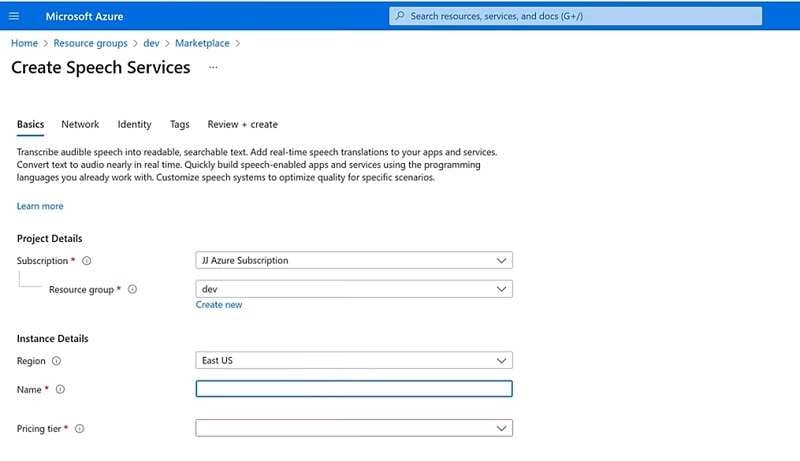
Die Microsoft Azure Speech API ist Teil von Azures Suite kognitiver Dienste. Für die kostenlose Nutzung bietet die Microsoft Azure Speech API einen kostenlosen Tarif mit begrenzter Nutzung. Der Tarif ist ideal für kleine Projekte, Tests und Lernzwecke. Er umfasst Funktionen wie Echtzeit-Transkription und anpassbare Sprachmodelle. Weitere Details finden Sie auf der Preisseite von Microsoft Azure.
Hauptfunktionen
- Protokolle für jeden Endpunkt auf Anfrage für diesen spezifischen Endpunkt abrufen
- Zugriff auf das Manifest der von Ihnen erstellten Modelle, um On-Premises-Container einzurichten
- Daten aus Azure-Speicherkonten mithilfe einer Shared Access Signature (SAS) URI hochladen
- Eigene Speicherkonten zur Verwaltung von Protokollen, Transkriptionsdateien und anderen Daten verwenden
- Audiodateien aus mehreren URLs oder einem Azure-Container stapelweise transkribieren
Einschränkungen
- Der kostenlose Tarif erlaubt nur das Hosten eines benutzerdefinierten Sprachmodells pro Monat und nur 5 Audiostunden kostenlos pro Monat
- Obwohl Azures Transkription im Allgemeinen genau ist, hat sie gelegentlich Schwierigkeiten bei der korrekten Schreibweise von Wörtern
- Die Ersteinrichtung der Azure Speech API kann komplex sein
Ideal für: Branchen wie Gesundheitswesen, Finanzen oder Rechtsdienstleistungen, in denen häufig Fachterminologie verwendet wird.
3. Speechmatics
Speechmatics bietet eine Sprache-zu-Text-API mit einem großzügigen kostenlosen Plan, der Nutzern 8 Stunden Transkription pro Monat zur Verfügung stellt. Dieser Plan umfasst 4 Stunden für die Stapelverarbeitung und weitere 4 Stunden für die Echtzeit-Transkription. Speechmatics ist auf Flexibilität ausgelegt und bedient verschiedene Anwendungen, von der Medienproduktion bis zum Kundenservice. Sie können seine fortschrittlichen maschinellen Lernalgorithmen nutzen, um auch in schwierigen Audioumgebungen hohe Genauigkeit und zuverlässige Ergebnisse zu erzielen.
Hauptfunktionen
- Unterstützt rund 50 Sprachen und bietet umfassende Abdeckung für verschiedene Akzente und Dialekte.
- Die API liefert Echtzeit-Transkription mit einer Latenz von weniger als einer Sekunde
- Automatische Erkennung der gesprochenen Sprache
- Jedes Wort in der Transkription wird mit einem präzisen Zeitstempel versehen
- Transkripte als SRT-Untertitel exportieren
Einschränkungen
- Die Einrichtung erfordert die Konfiguration benutzerdefinierter Schnittstellen, was es eher für Unternehmen mit technischen Ressourcen geeignet macht.
- Aufgrund technischer Anforderungen nicht für kleinere Unternehmen oder Projekte geeignet
Ideal für: Großangelegte Unternehmens-Transkriptionsanforderungen.
4. AssemblyAI
AssemblyAI stellt KI-gestützte Sprachmodelle über eine API bereit. Als neuer Nutzer erhalten Sie ein kostenloses Guthaben von 50 $ zum Starten. Diese API unterstützt verschiedene Sprachdatenaufgaben, darunter Sprecher-Diarisierung, Themenerkennung, Stimmungsanalyse und Textzusammenfassung. Es sind zwei Sprache-zu-Text-Optionen verfügbar: „Best" für hohe Genauigkeit und „Nano" für kosteneffiziente Transkription.
Hauptfunktionen
- Sprecher-Diarisierung zur Identifizierung und Trennung verschiedener Sprecher in einer Audioaufnahme
- Benutzerdefinierte Schreibweise und Vokabular, bei dem Sie benutzerdefinierte Wörter oder Fachterminologie für eine genaue Transkription eingeben können
- Automatische Zensur unangemessener Sprache und Anwendung korrekter Interpunktion und Groß-/Kleinschreibung für bessere Lesbarkeit
Einschränkungen
- Die Plattform bietet im Vergleich zu einigen Mitbewerbern weniger Sprachen
- Gelegentliche Fehler und Probleme können Zeit in Anspruch nehmen, bis sie behoben werden
- Das Tool hat häufig Schwierigkeiten mit der Transkriptionsgenauigkeit, wenn Audio erhebliche Hintergrundgeräusche oder Störungen aufweist
Ideal für: Transkription von Meetings, Interviews oder Podcasts mit mehreren Sprechern.
5. AWS Transcribe
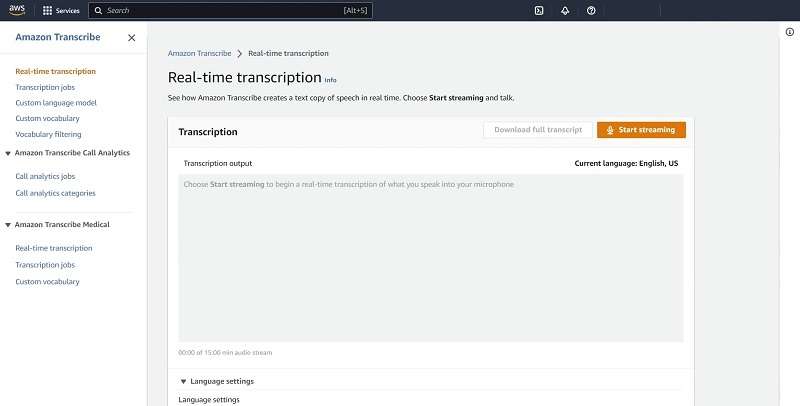
Amazon Transcribe, Teil von AWS, ermöglicht neuen Nutzern eine Stunde kostenlose Transkription pro Monat während ihres ersten Jahres. Dieser Dienst ermöglicht es Nutzern, Audio für verschiedene Zwecke in Text umzuwandeln, erfordert jedoch die Speicherung von Audiodateien in Amazon S3.
Hauptfunktionen
- Interpunktions- und Formatierungsoptionen
- Benutzerdefiniertes Vokabular für branchenspezifische Begriffe
- Mehrfach-Sprecher-Identifikation
- Transkribiert Live-Audio-Streams oder vorab aufgezeichnete Sprache in Text
Einschränkungen
- Erfordert Audiospeicherung in Amazon S3
- Kann bestimmte Wörter übersehen, insbesondere Eigennamen oder benannte Entitäten (NER)
Ideal für: Unternehmen, die automatisierte Transkription für Meetings, Medien oder Kundensupport benötigen
Teil 2. Erste Schritte mit der Sprache-zu-Text API-Integration
Um mit der Integration der Sprache-zu-Text-API zu beginnen, stellt jeder Dienst in der Regel detaillierte Dokumentationen und Ressourcen bereit, die Entwickler durch den Einrichtungsprozess führen. In der Regel beginnen Sie damit, ein Konto beim Anbieter zu erstellen. Anschließend generieren Sie einen API-Schlüssel, der den Zugriff auf den Dienst ermöglicht.
Als Demonstration stellt eine der beliebtesten Spracherkennungs-APIs, Google Cloud Speech-to-Text, eine Google Cloud Speech-to-Text API-Dokumentation hier bereit. Der Prozess umfasst mehrere wichtige Schritte:
- Google Cloud-Projekt erstellen: Registrieren Sie sich für ein Google Cloud-Konto und erstellen Sie ein neues Projekt in der Google Cloud Console. Dieses Projekt verwaltet Ihre API-bezogenen Ressourcen.
- Die Speech-to-Text API aktivieren: Navigieren Sie zum Abschnitt API & Dienste, suchen Sie nach der Speech-to-Text API und aktivieren Sie sie für Ihr Projekt.
- API-Anmeldedaten generieren: Erstellen Sie ein Dienstkonto und generieren Sie einen API-Schlüssel, den Sie zur Authentifizierung Ihrer Anfragen verwenden werden. Laden Sie die Schlüsseldatei (normalerweise im JSON-Format) herunter, um Ihre Anmeldedaten zu speichern.
- Client-Bibliothek einrichten: Installieren Sie die erforderlichen Client-Bibliotheken (wie Python, Java oder Node.js), um programmgesteuert mit der API zu interagieren. Die Client-Bibliotheken vereinfachen die Erstellung von API-Anfragen und die Verarbeitung von Antworten.
- Code zur Transkription von Audio schreiben: Verwenden Sie den API-Schlüssel und die Client-Bibliothek, um Code zu schreiben, der Audio in Text umwandelt, indem Audiodaten zur Verarbeitung an die Server von Google Cloud gesendet werden.
Sehen Sie sich hier das vollständige Tutorial an, wie Sie die kostenlose Google Cloud Sprache-zu-Text-API in Ihre App integrieren.
Teil 3. Beste Lösung zur Verwendung von Sprache-zu-Text ohne API-Integration
Nicht jeder Nutzer oder jedes Unternehmen muss APIs integrieren, da die Einrichtung komplex, zeitaufwendig und für kleinere Projekte oder einzelne Nutzer manchmal unnötig sein kann. Stattdessen gibt es eine andere Möglichkeit, Sprache ohne API-Integration in Text umzuwandeln. Eine solche Option ist Wondershare Filmoras Sprache-zu-Text Funktion.
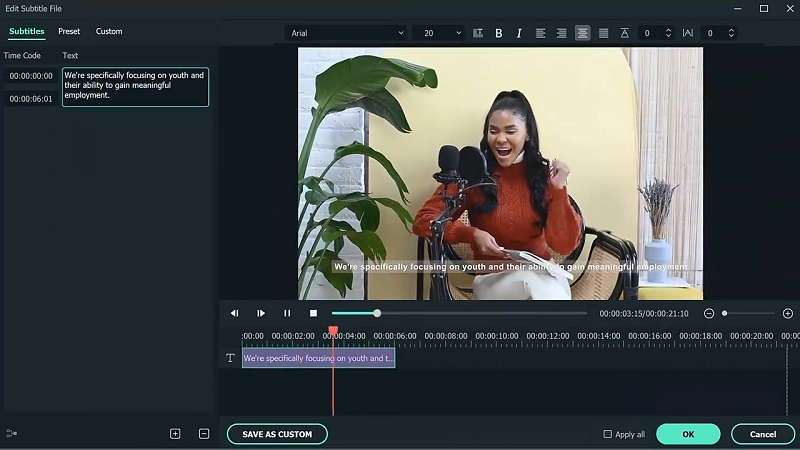
Filmoras Sprache-zu-Text-Funktion
Filmora ist ein beliebtes Videobearbeitungstool, das mit einer integrierten Sprache-zu-Text-Funktion ausgestattet ist. Sie können damit gesprochene Wörter in Audio- oder Videodateien direkt in Text umwandeln. Diese Funktion ist eine unkomplizierte Lösung zur schnellen Erstellung von Untertiteln, Bildunterschriften oder Transkripten. Sie müssen sich keine Gedanken über manuelle Transkription oder komplexe Einrichtungen machen – der Prozess ist vollständig automatisiert.
Wenn Sie außerdem an mehrsprachigen Projekten arbeiten oder Inhalte in verschiedenen Sprachen transkribieren müssen, unterstützt Filmoras Sprache-zu-Text-Funktion auch mehrere Sprachen, darunter Englisch, Französisch, Spanisch, Indonesisch, Hindi, Japanisch und mehr.
Wann sollte man Filmoras Sprache-zu-Text-Funktion der API-Integration vorziehen?
- Nicht-technische Benutzer: Wenn Sie keinen technischen Hintergrund oder kein Entwicklungsteam haben, macht die benutzerfreundliche Oberfläche von Filmora die API-Integration überflüssig.
- Projekte mit schneller Umsetzung: Wenn Sie Inhalte schnell für Untertitel, Beschriftungen oder kurze Videoprojekte transkribieren müssen, spart der vollautomatische Prozess von Filmora im Vergleich zur manuellen Einrichtung von API-Diensten Zeit.
- Arbeiten mit Videoinhalten: Da Filmora Videobearbeitung und Spracherkennungsfunktionen auf einer Plattform kombiniert, können Sie den transkribierten Text direkt auf Ihre Videoprojekte für Beschriftungen, Untertitel oder Transkripte anwenden, ohne zwischen Tools wechseln zu müssen.
Schritt für Schritt: Sprache-zu-Text mit Filmora verwenden
Schritt 1: Filmora öffnen und Ihre Audiodatei importieren
Stellen Sie sicher, dass die neueste Version von Filmora auf Ihrem Computer installiert ist. Starten Sie dann Filmora und wählen Sie Neues Projekt aus, um ein neues Projekt zu erstellen.
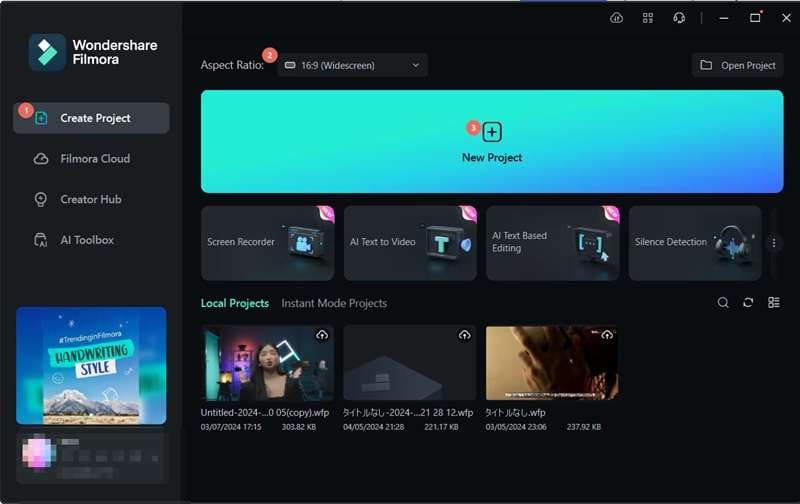
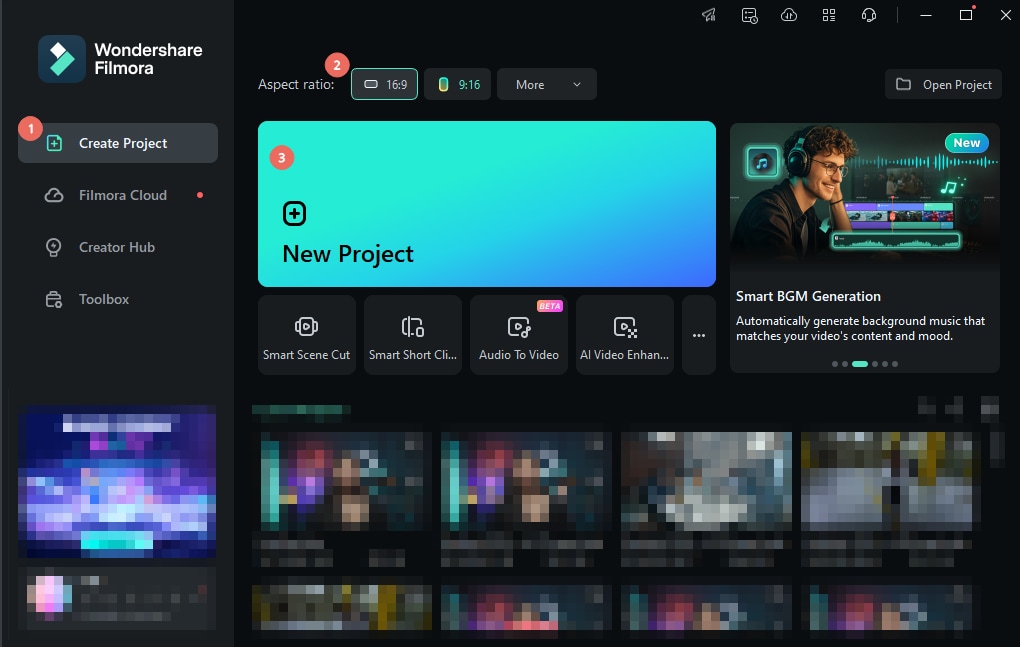
Um Ihre Audiodatei hochzuladen, klicken Sie auf Importieren und wählen Sie die Datei von Ihrem Computer aus.
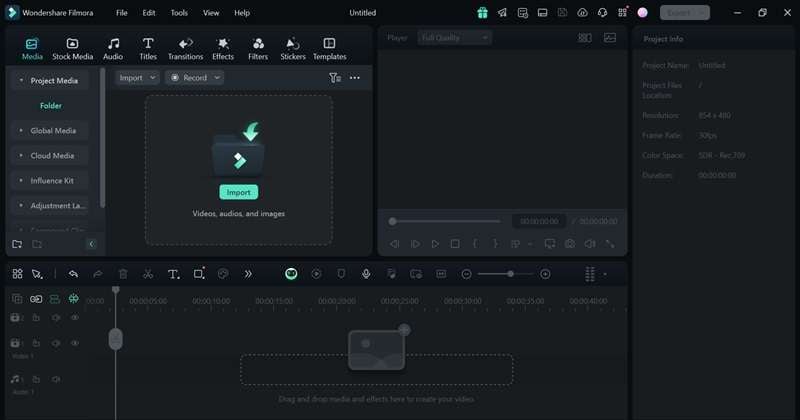
Schritt 2: Auf das Sprache-zu-Text-Tool zugreifen
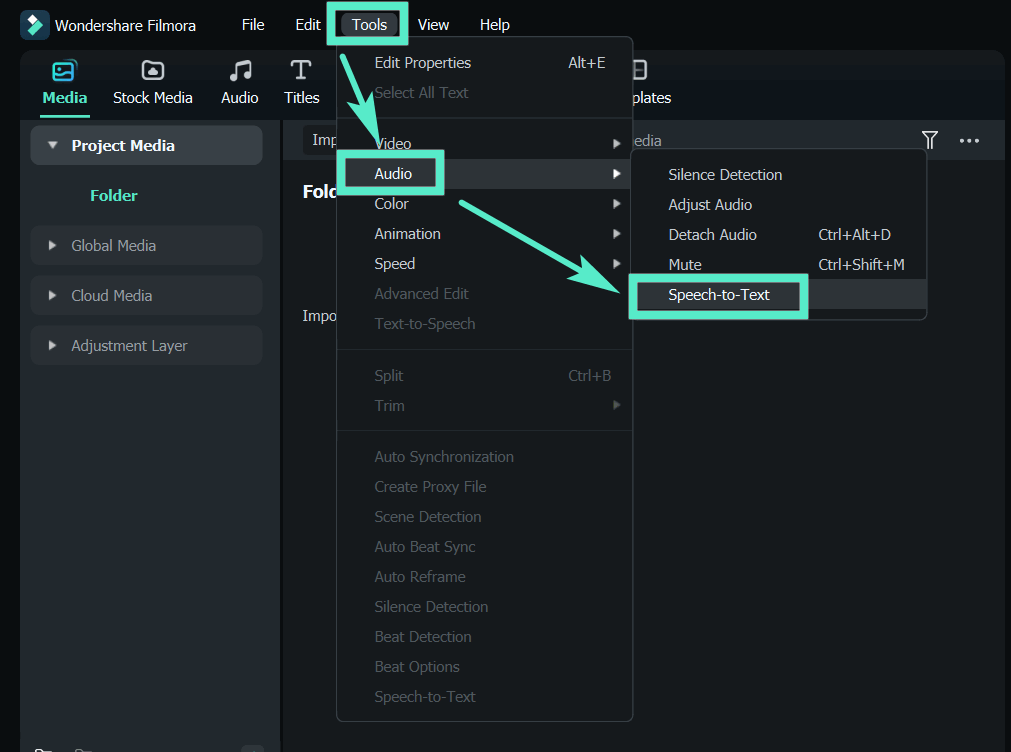
Sobald Ihre Audiodatei importiert wurde, ziehen Sie sie in die Zeitleiste. Um das Sprache-zu-Text-Tool zu aktivieren, wählen Sie die Audiospur in der Zeitleiste aus. Gehen Sie dann zu Extras > Audio > Sprache zu Text.
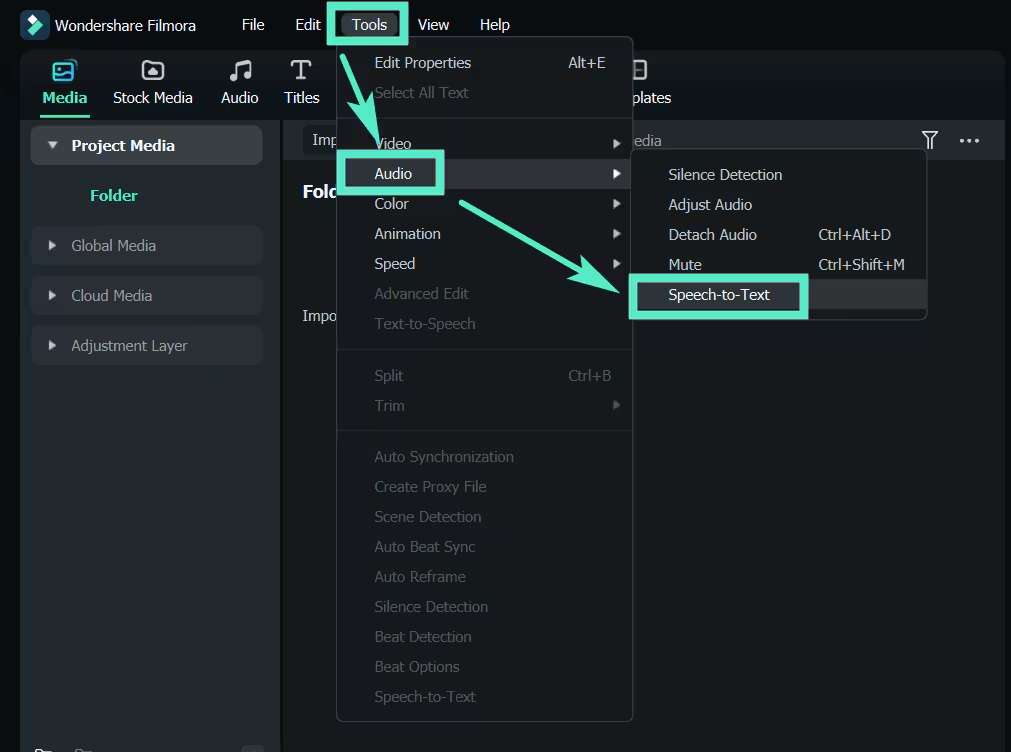
Schritt 3: Transkriptionseinstellungen festlegen
Ein Konfigurationsfenster für die Sprache-zu-Text-Funktion wird angezeigt. Hier können Sie die Sprache der Audiodatei auswählen, die Sie transkribieren möchten. Wenn Sie die Sprache nicht übersetzen lassen möchten, wählen Sie die Option "Keine Übersetzung" unter dem Abschnitt „Sprache, in die übersetzt werden soll".
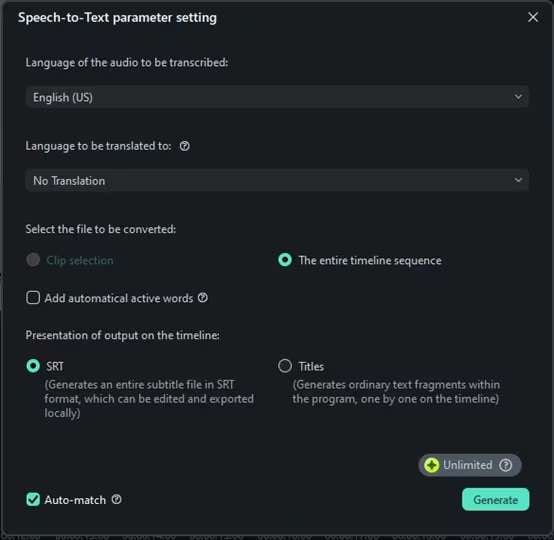
Sie können auch entscheiden, ob nur der ausgewählte Audioclip oder die gesamte Zeitleiste transkribiert werden soll. Wählen Sie anschließend SRT-Datei als Ausgabeformat.
Schritt 4: Transkription der Audiodatei starten
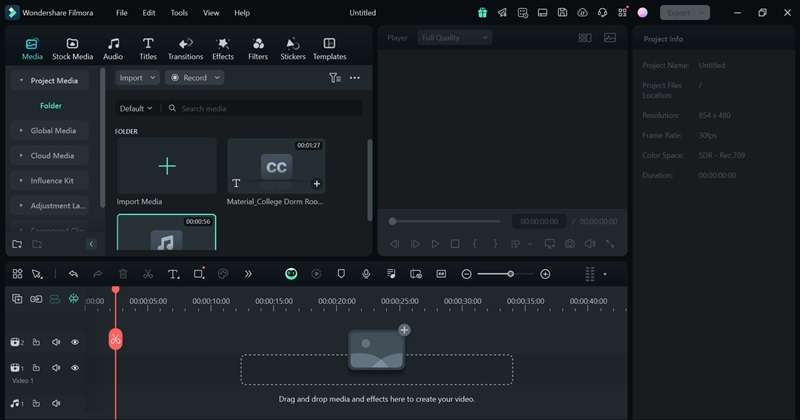
Sobald alle Einstellungen vorgenommen sind, klicken Sie auf die Schaltfläche Generieren . Filmora verarbeitet die Audiodatei und erstellt die Transkription. Wenn der Vorgang abgeschlossen ist, ist die Transkriptionsdatei im Medien Tab verfügbar.
Schritt 5: Transkription bearbeiten
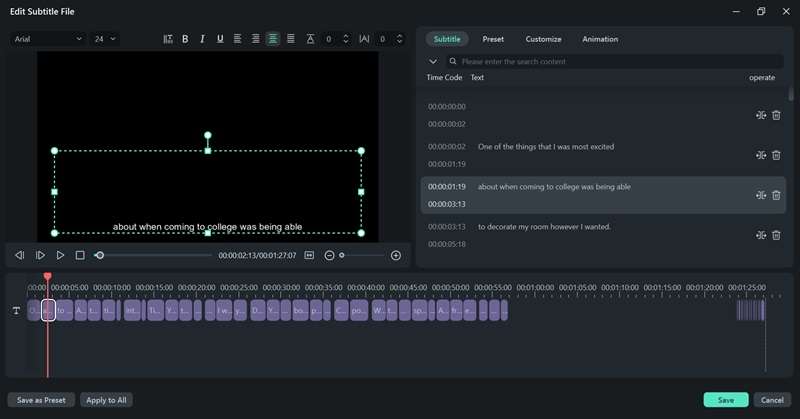
Wenn Sie die Transkription anpassen müssen, doppelklicken Sie auf die generierte Transkriptionsdatei, um die Bearbeitungsoberfläche zu öffnen. Hier können Sie den Text überprüfen und notwendige Korrekturen vornehmen. Für einen effizienteren Überprüfungsprozess können Sie auch\u00a0Intelligente Textkorrektur in den Sprache-zu-Text-Einstellungen aktivieren. Diese Funktion hebt potenziell fehlerhafte Untertitelabschnitte automatisch hervor und gibt intelligente Korrekturvorschläge, bevor Sie die Untertitel fertigstellen.\u00a0
Schritt 6: Transkription speichern oder zum Projekt hinzufügen
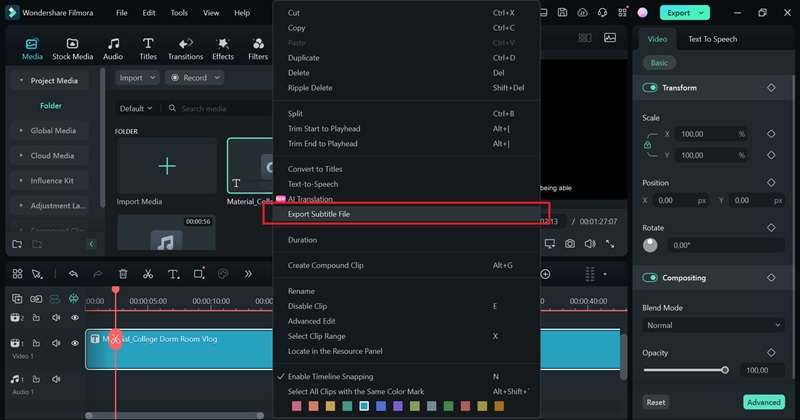
Nachdem Sie alle notwendigen Bearbeitungen vorgenommen haben, können Sie die Transkription als SRT-Datei exportieren. Klicken Sie mit der rechten Maustaste auf die Texttranskriptionsspur in der Zeitleiste und wählen Sie „Untertiteldatei exportieren".
Fazit
Kostenlose Sprache-zu-Text-APIs helfen Entwicklern, Transkription in ihre Anwendungen zu integrieren, ohne hohe Kosten zu verursachen. In unserem heutigen Artikel haben wir einige der besten Tools auf dem Markt bewertet, darunter Google Cloud Speech-to-Text, Microsoft Azure, Speechmatics, AssemblyAI und AWS Transcribe. Egal ob Sie an kleinen Projekten arbeiten oder Spracherkennung für Ihr Projekt testen – diese kostenlosen Optionen sind ein solider Ausgangspunkt.
Wenn Sie jedoch nach einer nicht-technischen Lösung suchen, kann die integrierte Sprache-zu-Text-Funktion von Filmora eine hervorragende Alternative sein. Sie vereinfacht den Prozess, insbesondere für Videoersteller oder Unternehmen, die eine schnelle Transkription ohne die Komplexität von API-Integrationen benötigen.